第一步 申請並貼上你的 Groq API Key
尚未設定 點開申請 免費 不用綁信用卡
1
打開 console.groq.com
用 Google 帳號登入
2
先點 這個語音模型頁
按 Accept terms 同意條款
站 3 語音會用到 現在按好 30 秒的事
3
開 API Keys 頁 按 Create API Key
跟步驟 2 連著做 中間不要切換 Console 左上角的組織
4
複製 gsk_ 開頭的 Key
貼到下面輸入框 就完成了
安全提醒 Key 只存在你瀏覽器的 localStorage 不會上傳任何伺服器 所有 API 呼叫都從你的瀏覽器直接打到 Groq 共用電腦記得用完按清除
回想 Round 2 這種「Key 貼在瀏覽器」只適合自己練習 做給別人用的網站要像會議摘要器一樣把 Key 藏在後端
回想 Round 2 這種「Key 貼在瀏覽器」只適合自己練習 做給別人用的網站要像會議摘要器一樣把 Key 藏在後端
今天的路線 站 1 的逐字稿會自動流進站 3 和站 4 這就是 API 串接
1 聽 你講話
→
逐字稿
→
3 說 英文朗讀
+
4 貼標籤 JSON
站 2 看圖是獨立支線 用同一把 Key 換一個模型就能看圖 四站用完你就體會過語音 視覺 語音合成 結構化輸出四種 API
1
聽 講一段話 秒出逐字稿
whisper-large-v3-turbo ・ 語音轉文字
真實世界對應
會議記錄 客服錄音質檢 訪談逐字稿
會議記錄 客服錄音質檢 訪談逐字稿
按下錄音 照著下面任一段講稿唸 唸完按停止 你的聲音會送到 Whisper 模型 回來就是文字 這段文字等下會餵給站 3 和站 4
講稿 A 客訴
講稿 B 詢價
講稿 C 課後回饋
0:00
不方便開麥克風?(mp3 / m4a / wav)
逐字稿會出現在這裡
▸ 這一站背後打的 API 長這樣(你的程式也能打)
curl https://api.groq.com/openai/v1/audio/transcriptions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -F model=whisper-large-v3-turbo \
  -F response_format=verbose_json \
  -F [email protected]
2
看 丟一張發票 抽出品項和金額
meta-llama/llama-4-scout-17b-16e-instruct ・ 圖片理解
真實世界對應
報帳自動化 表單辨識 商品圖整理
報帳自動化 表單辨識 商品圖整理
已經幫你放了一張示範發票 直接按辨識 也可以手機拍你桌上任何收據或名片換上去試
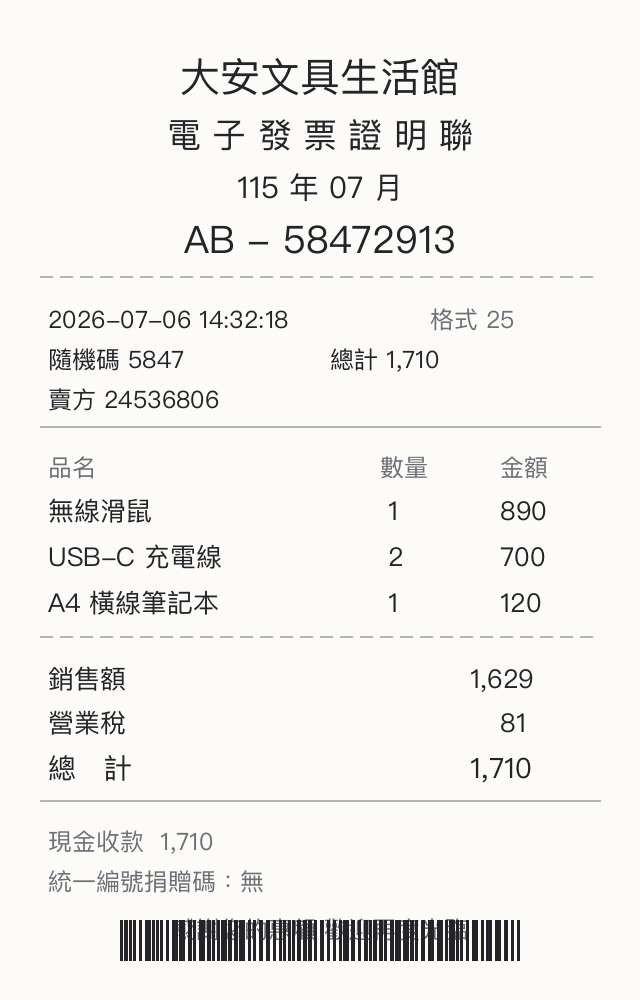
點圖片也能換圖 或直接把圖拖進來
要 AI 做什麼(可以改)
辨識結果會出現在這裡
▸ 這一站背後打的 API 長這樣
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"meta-llama/llama-4-scout-17b-16e-instruct",
       "messages":[{"role":"user","content":[
         {"type":"text","text":"抽出這張發票的品項和金額"},
         {"type":"image_url","image_url":{"url":"data:image/jpeg;base64,..."}}]}]}'
3
說 把逐字稿翻成英文 AI 開口唸給你聽
llama-3.3-70b-versatile 翻譯 + canopylabs/orpheus-v1-english 語音合成
真實世界對應
語音通知 有聲內容 無障礙朗讀
語音通知 有聲內容 無障礙朗讀
Orpheus 語音模型目前只會說英文和阿拉伯文 所以中文逐字稿要先過一次翻譯 API 再送語音 API 兩個 API 手牽手 就是串接 這也是查證模型能力邊界的一課 不是每個模型什麼都會
被擋說要同意條款? 那是最上方申請流程的步驟 2 還沒做 點這裡開 Orpheus 模型頁 按 Accept terms 回來重試
按過了還是被擋 代表 Key 跟條款同意的不是同一個組織 在剛剛按同意的那個組織重開一把新 Key 回來換上即可
按過了還是被擋 代表 Key 跟條款同意的不是同一個組織 在剛剛按同意的那個組織重開一把新 Key 回來換上即可
中文原文(站 1 唸完會自動帶入)
英文版(也可以直接改)
▸ 這一站背後打的 API 長這樣
curl https://api.groq.com/openai/v1/audio/speech \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"canopylabs/orpheus-v1-english",
       "voice":"hannah",
       "input":"Your English text here",
       "response_format":"wav"}' \
  --output speech.wav
4
貼標籤 一段話進去 結構化 JSON 出來
llama-3.3-70b-versatile ・ JSON mode
真實世界對應
客訴分流 輿情監控 表單自動歸檔
客訴分流 輿情監控 表單自動歸檔
把站 1 的逐字稿(或任何一段客戶訊息)丟進來 AI 回的不是文章 是固定欄位的 JSON 分類 情緒 緊急度 一秒變成彩色標籤 這就是客服系統自動分流的原理
範例 A 客訴
範例 B 詢價
範例 C 課後回饋
輸出結果
一句話摘要
建議下一步
程式實際收到的原始 JSON
看懂了嗎 ChatGPT 的答案是給人看的 API 的答案是給程式吃的 上面每個欄位都能直接接進你的系統 資料庫 報表 通知 這就是 API 跟聊天視窗的分水嶺
▸ 這一站背後打的 API 長這樣
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"llama-3.3-70b-versatile",
       "response_format":{"type":"json_object"},
       "messages":[
         {"role":"system","content":"你是客服訊息分析器 只輸出 JSON..."},
         {"role":"user","content":"客戶訊息"}]}'
玩完四站之後想一想 剛剛每一站都是「你的瀏覽器 直接打 Groq API」 如果要把這些做成給客戶用的正式網站 Key 該放哪裡?答案就是 Round 3 的三層架構 前端 GitHub Pages + 後端 GAS 藏 Key